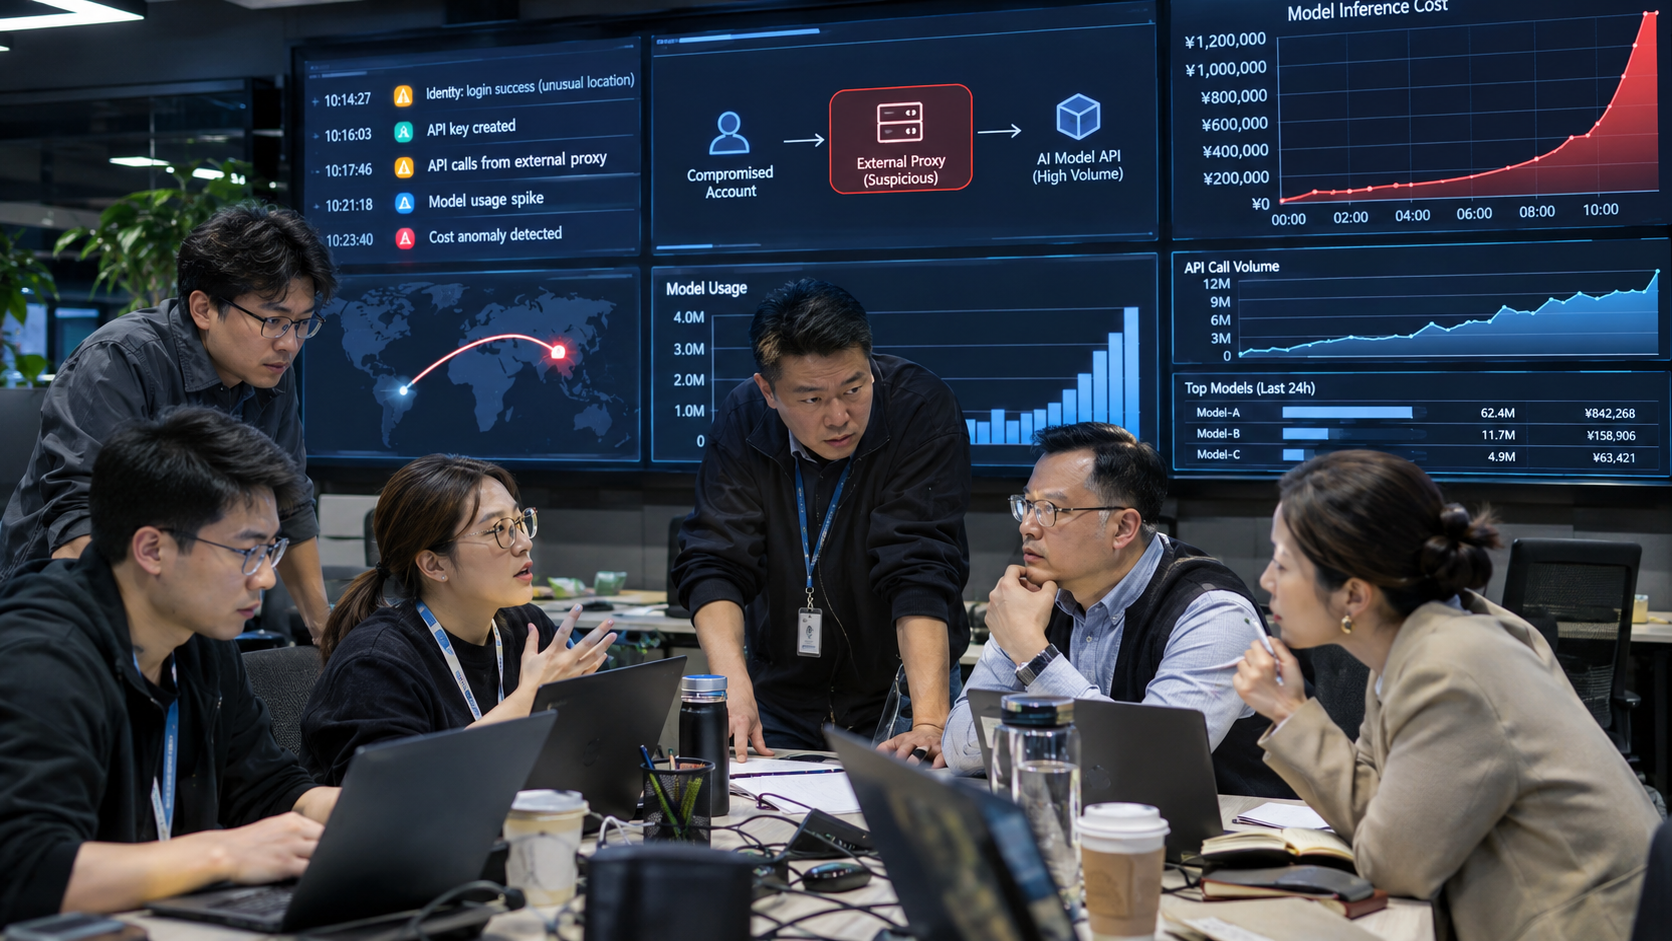
企业看到 AI 调用量上涨,第一反应往往是业务增长、程序循环或预算失控。现在还要增加第四种可能:攻击者正在用企业凭证调用高价模型,并把盗来的算力转卖给地下用户。
2026 年 11 月 2 日,Google Threat Intelligence Group 与 Mandiant 发布 LLMJacking 调查。报告称,Mandiant 在 2026 年处置了多起企业大模型访问被劫持的事件,涉及金融、零售、科技和交通等行业。个别事件一天产生的欺诈性资源费用超过 10 万美元,有的组织在撤销访问前累计接近 100 万美元。
这不是传统意义上的“有人盗用了一个 API Key”那么简单。攻击者已经形成分工:有人负责窃取云身份与模型凭证,有人搭建代理网关聚合多家受害者的额度,再以远低于正常市场价格的方式向地下客户出售模型访问。
当 AI 用量本身可以被快速变现,异常账单就不只是财务问题,而是安全入侵的实时信号。
LLMJacking 偷的不是数据,而是企业的“购买力”
传统数据泄露的目标通常是客户信息、知识产权或账号。LLMJacking 的直接目标,是企业已经获得的模型访问权、云配额和付款能力。
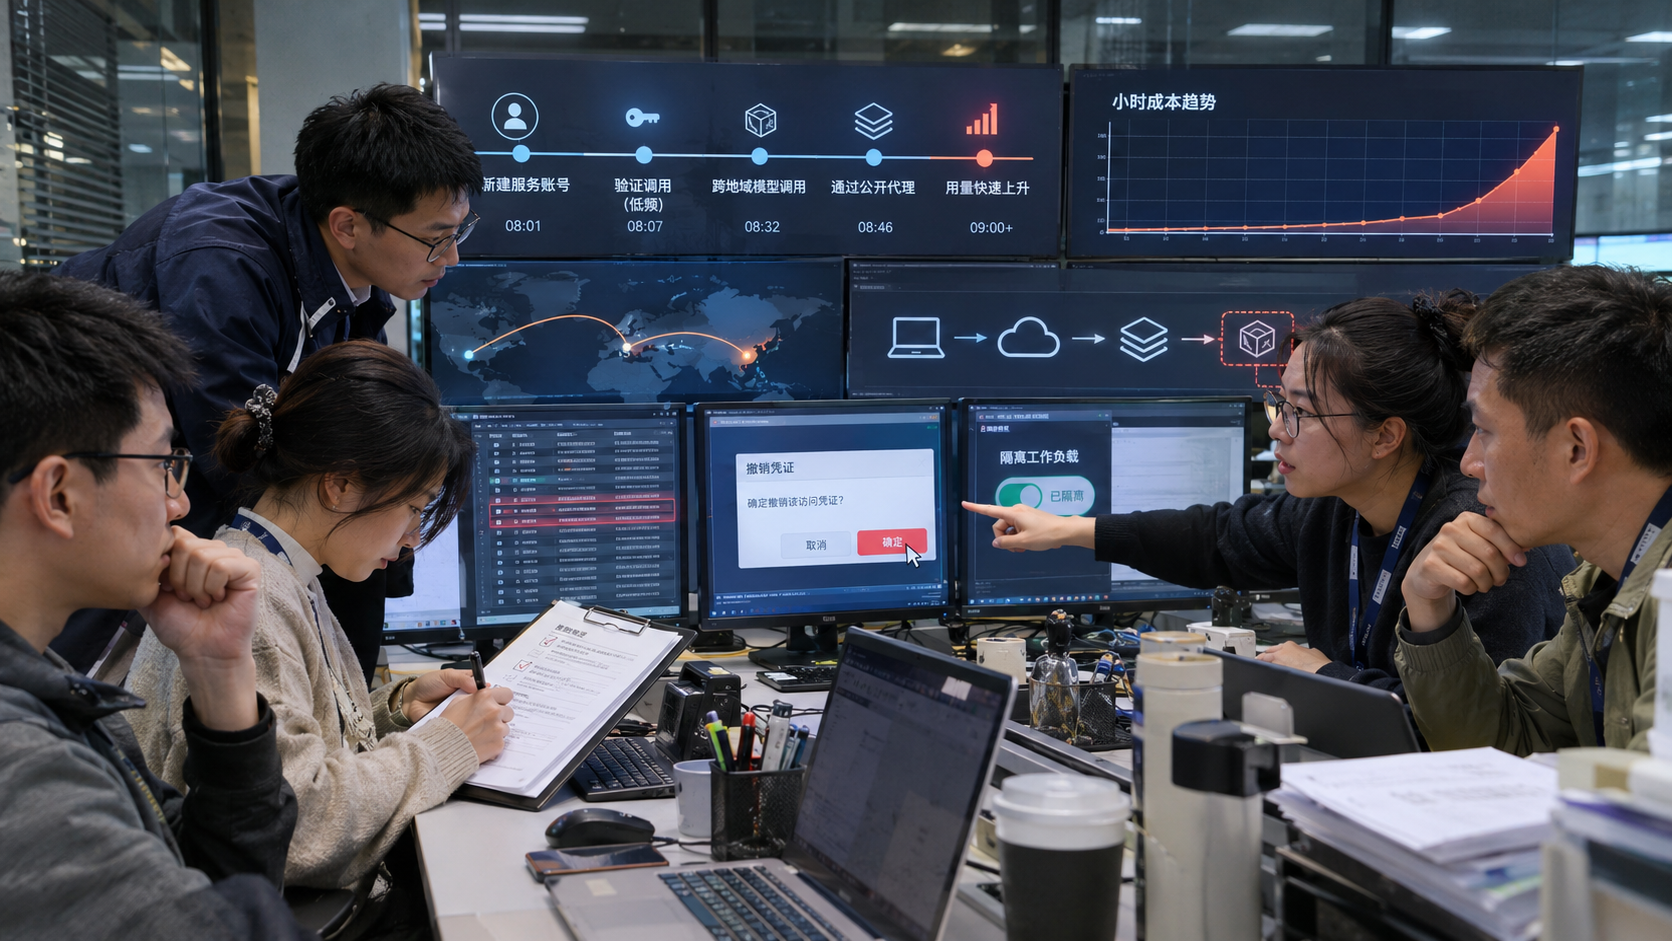
一次典型攻击可能沿着这条路径发展:
Google 报告中的一个案例,在不到八小时内执行了超过 50 万次模型 API 调用。另一些攻击者会持续创建和删除短期服务账号,轮换使用额度,并查看云账单以掌握对受害企业造成的财务影响。
因此,LLMJacking 既是身份攻击、云配置攻击和供应链攻击,也是具有明确商业模型的资源盗窃。
- 攻击者从公开代码库、错误配置、被入侵终端或钓鱼页面获取云令牌、服务账号密钥、代码仓库令牌或模型 API Key;
- 用极小请求验证凭证是否有效,避免在初期制造明显流量;
- 枚举可用模型、区域、配额和身份权限,寻找更高价能力;
- 创建新密钥、服务账号或模型部署,扩大访问并保持持久性;
- 架设代理或模型网关,把企业模型访问包装成对外服务;
- 通过大量推理、流式调用或 GPU 实例快速变现,把费用留给受害企业。
为什么传统安全监控容易错过第一步
攻击者验证模型凭证时,不需要立即生成大量文本。Google 报告提到,有攻击者使用 `max_tokens=1` 的极小请求自动测试密钥;请求合法、流量很低,也可能来自常见 SDK,传统的终端防护和大流量告警不一定会立即触发。
真正的大额消耗往往发生在验证成功之后。这意味着,如果企业只监控“调用量是否突然暴涨”,发现时攻击者可能已经完成了账号持久化、权限升级和代理部署。
更早的信号通常来自控制面,而不是账单总额:
这些事件分散在 IAM、代码仓库、云审计、模型网关、网络和计费系统中。任何一个团队单独观察,都可能只看到局部异常。
- 一个此前未使用模型服务的项目突然启用了相关 API;
- 普通工作负载开始枚举模型、端点和可用区域;
- 出现新的服务账号、访问密钥、模型部署或配额提升申请;
- 非基础设施即代码账号修改日志、诊断或审计配置;
- 模型网关、容器或虚拟机开始接受公网连接;
- 低量探测后迅速转为高并发调用;
- 请求来源、模型等级、时段或区域与历史基线明显不符。
安全团队与 FinOps 必须共用一张时间线
很多企业仍把两类告警分开处理:安全团队看身份、网络和漏洞,FinOps 看费用、折扣和预算。LLMJacking 打破了这种分工,因为“未经解释的模型费用”本身就是入侵指标,而“新增密钥与服务启用”又可能预示即将发生的财务损失。
企业可以建立一条联合检测链:
关键不是再建一个大屏,而是让两类信号能够关联到同一个项目、模型、身份、密钥和时间段,并明确谁有权立即止损。
- 阶段:安全信号:成本信号:推荐响应
- 凭证探测:极小请求、异常 User-Agent、新来源地址:金额很低或不可见:核验身份、限制来源、提高风险评分
- 环境侦察:枚举模型与端点、查看 IAM 和日志配置:尚无明显增长:阻断会话、检查横向移动
- 能力扩张:启用模型服务、创建密钥、申请配额、部署代理:预计费用斜率上升:冻结变更、撤销凭证、隔离工作负载
- 批量滥用:高频推理、跨区域调用、高价模型异常使用:分钟或小时级暴涨:限流或熔断、启动事件响应
- 处置恢复:删除后门账号、修补网关、轮换密钥:费用下降但可能仍有延迟:核对账单、验证残留权限、受控恢复
Spend Cap 能止血,但不能证明环境已经安全
费用硬上限、API 配额和速率限制可以显著缩小损失范围。Google 的处置建议也包括按模型设置细粒度配额、预算上限和客户端限流。
但达到上限后暂停服务,只说明新的费用暂时停止,并不意味着攻击者已经离开。他可能仍持有云身份,已经创建后门服务账号,获得代码仓库与数据库凭证,或关闭了部分日志。如果团队看到费用停止就结束事件,恢复服务后攻击可能继续。
因此,成本熔断之后至少要完成四项安全确认:
硬上限是财务止血带,不是安全清除证明。
- 撤销被盗令牌、会话、密钥及其派生凭证;
- 查找异常服务账号、SSH Key、权限策略、模型部署和公网端点;
- 修补最初入口,包括代码泄密、应用漏洞和模型网关漏洞;
- 验证日志没有被关闭或篡改,并回溯是否发生数据访问与横向移动。
最值得先改的,是密钥如何被创建和使用
Google 报告显示,暴露或被盗的云身份令牌是多起事件的主要初始入口,既包括服务账号密钥,也包括 GitHub 个人访问令牌、IAM 凭证和活动会话。模型 API Key 只是其中一部分。
企业可以从五项基础治理开始:
尤其需要警惕“为了方便开发”而给服务账号过宽的项目权限。攻击者拿到的不是一把模型钥匙,而可能是一把能够再创建钥匙、启用服务和提高配额的总钥匙。
- 减少长期密钥:优先使用短时身份、工作负载身份和自动轮换;
- 缩小密钥能力:按环境、模型端点和用量分别授权,测试密钥不能调用高价生产模型;
- 扫描代码与构建产物:在提交、合并、镜像构建和发布环节检查密钥泄露;
- 默认禁止模型服务:没有明确业务需求的项目不应天然具备启用和调用模型的权限;
- 保护网关与路由层:把 LiteLLM 等模型代理纳入正式的漏洞、补丁、身份和日志管理。
事件演练要加入“凭证还活着,但用法不对”
传统密钥泄露演练常假设凭证已出现在公开仓库,团队据此轮换和排查。LLMJacking 的难点是,凭证可能没有公开,调用也可能完全通过正常 API 完成,只是使用者、目的和经济受益人发生了变化。
一次更贴近现实的演练可以这样设计:
演练结果不应只记录“几分钟内停止了费用”,还应记录:初始探测多久被发现、撤销覆盖了多少派生凭证、是否误停正常业务、遗漏了哪些日志,以及财务团队能否提供分钟级费用斜率。
- 在非生产环境模拟一个有效密钥从新地区发起极小验证请求;
- 随后模拟枚举模型、创建新密钥和申请高价模型访问;
- 逐步提高调用速率,观察安全与成本告警谁先发现;
- 验证值班人员是否能定位到身份、工作负载和责任项目;
- 执行限流、撤销、隔离与证据保全;
- 检查恢复服务前是否完成持久化与横向移动排查。
AI 成本异常正在成为新的入侵检测面
企业过去把云账单看作资源利用率和预算纪律的结果。LLMJacking 表明,AI 费用还可能反映身份失窃、权限扩张、网关漏洞和地下转售活动。
这要求安全运营增加一种新的判断:不是“这笔费用是否超过预算”,而是“这笔费用对应的使用者、业务目的和调用路径能否被解释”。无法解释的高增长当然危险,无法解释的低量探测同样值得关注。
当模型调用已经具备即时转售价值,攻击者不会等到月底账单生成才行动。企业也不能等。
真正有效的 AI 成本治理,不只是在钱花完前停下来,还要在第一笔异常费用出现时,判断它是不是一场正在发生的入侵。